Cómo un runner promedio carga sus entrenamientos
Ver la imagen, cambiar de pantalla, acordarme del ritmo, repetir. Lo cambié por un agente, una skill y una conexión a Garmin.
Entrené una CNN sobre 17.736 galaxias reales y el hallazgo no fue el accuracy, sino descubrir de dónde salían mis etiquetas.
Casi todos los cursos de deep learning parten con MNIST. Sirve para entender la base —yo mismo reforcé harto ahí— pero no es un problema que te obligue a razonar: los datos vienen limpios, balanceados, con las etiquetas perfectas, y tu única pega es elegir una arquitectura.
Quería lo contrario. Un dataset que me obligara a entender el problema real, a meterme en un área ajena a la IA, y a toparme con conceptos que no había visto. Terminé clasificando galaxias, y el hallazgo más interesante no fue ninguna métrica.
Fui siguiendo en paralelo el capítulo de clasificación de imágenes de Deep Learning with Python, de François Chollet.
Galaxy10 DECaLS: 17.736 imágenes de galaxias reales, 256×256 píxeles, en color, en
diez clases morfológicas. Todo en un solo archivo .h5 de 2,54 GB.
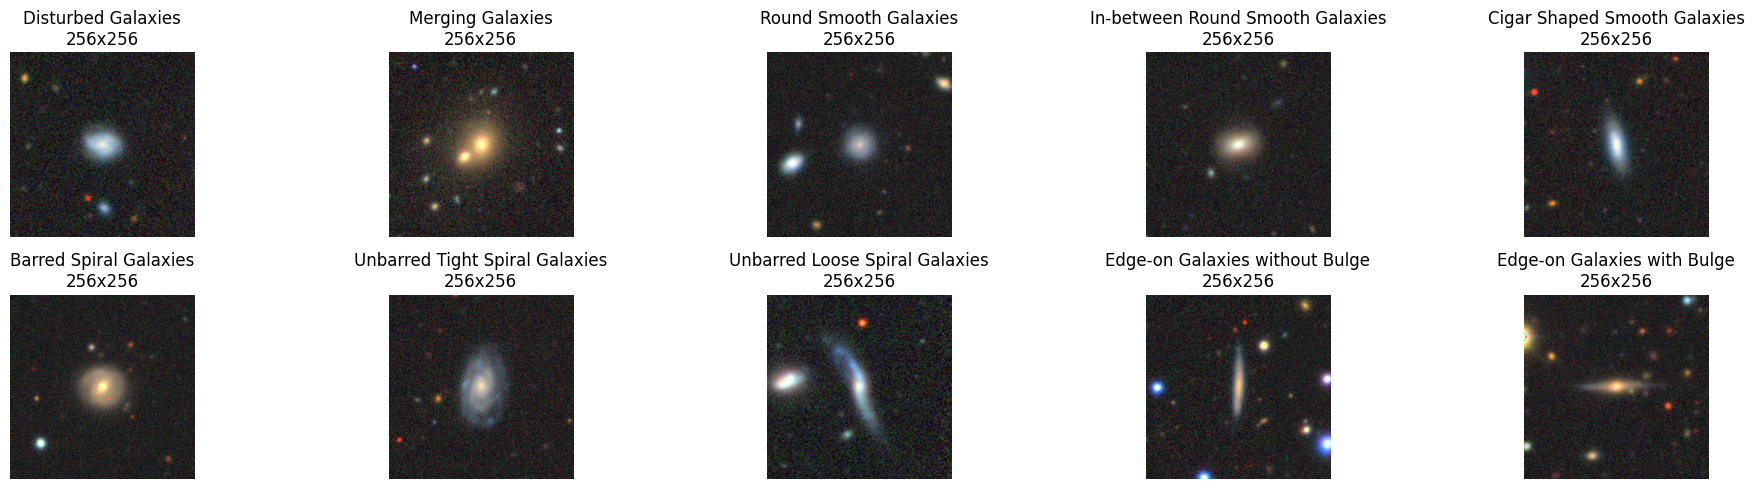
Lo primero que salta es el desbalance: casi 8 veces entre la clase más grande y la más chica.
| Clase | Imágenes |
|---|---|
| Round Smooth | 2.645 |
| Unbarred Loose Spiral | 2.628 |
| Barred Spiral | 2.043 |
| In-between Round Smooth | 2.027 |
| Edge-on con bulbo | 1.873 |
| Merging | 1.853 |
| Unbarred Tight Spiral | 1.829 |
| Edge-on sin bulbo | 1.423 |
| Disturbed | 1.081 |
| Cigar Shaped Smooth | 334 |
Acá está la parte que no esperaba.
Las etiquetas vienen de Galaxy Zoo, un proyecto de ciencia ciudadana donde voluntarios clasifican galaxias por internet. Pero a ningún voluntario le mostraron nunca estas diez clases. A la gente le hacen preguntas encadenadas sobre una imagen, y después alguien agregó esos votos y armó las categorías aplicando umbrales.
Eso significa dos cosas que me acompañaron todo el proyecto.
Primero, la “verdad” de cada galaxia no es una etiqueta: es una distribución de votos, y el umbral la aplasta a un entero. Cuando mi modelo se equivoca, puede que se haya equivocado de verdad, o puede que la galaxia fuera ambigua y alguien decidió por ella.
Segundo, las galaxias donde los voluntarios no se pusieron de acuerdo fueron filtradas: de unas 441 mil disponibles quedaron ~18 mil. Este dataset es un subconjunto de alto acuerdo, no una muestra representativa del cielo. Cualquier accuracy que yo reporte es optimista respecto a imágenes sin filtrar.
Antes de entrenar nada me metí a Galaxy Zoo a clasificar a mano. Quería entender de dónde salía mi variable objetivo: no leerlo, vivirlo.
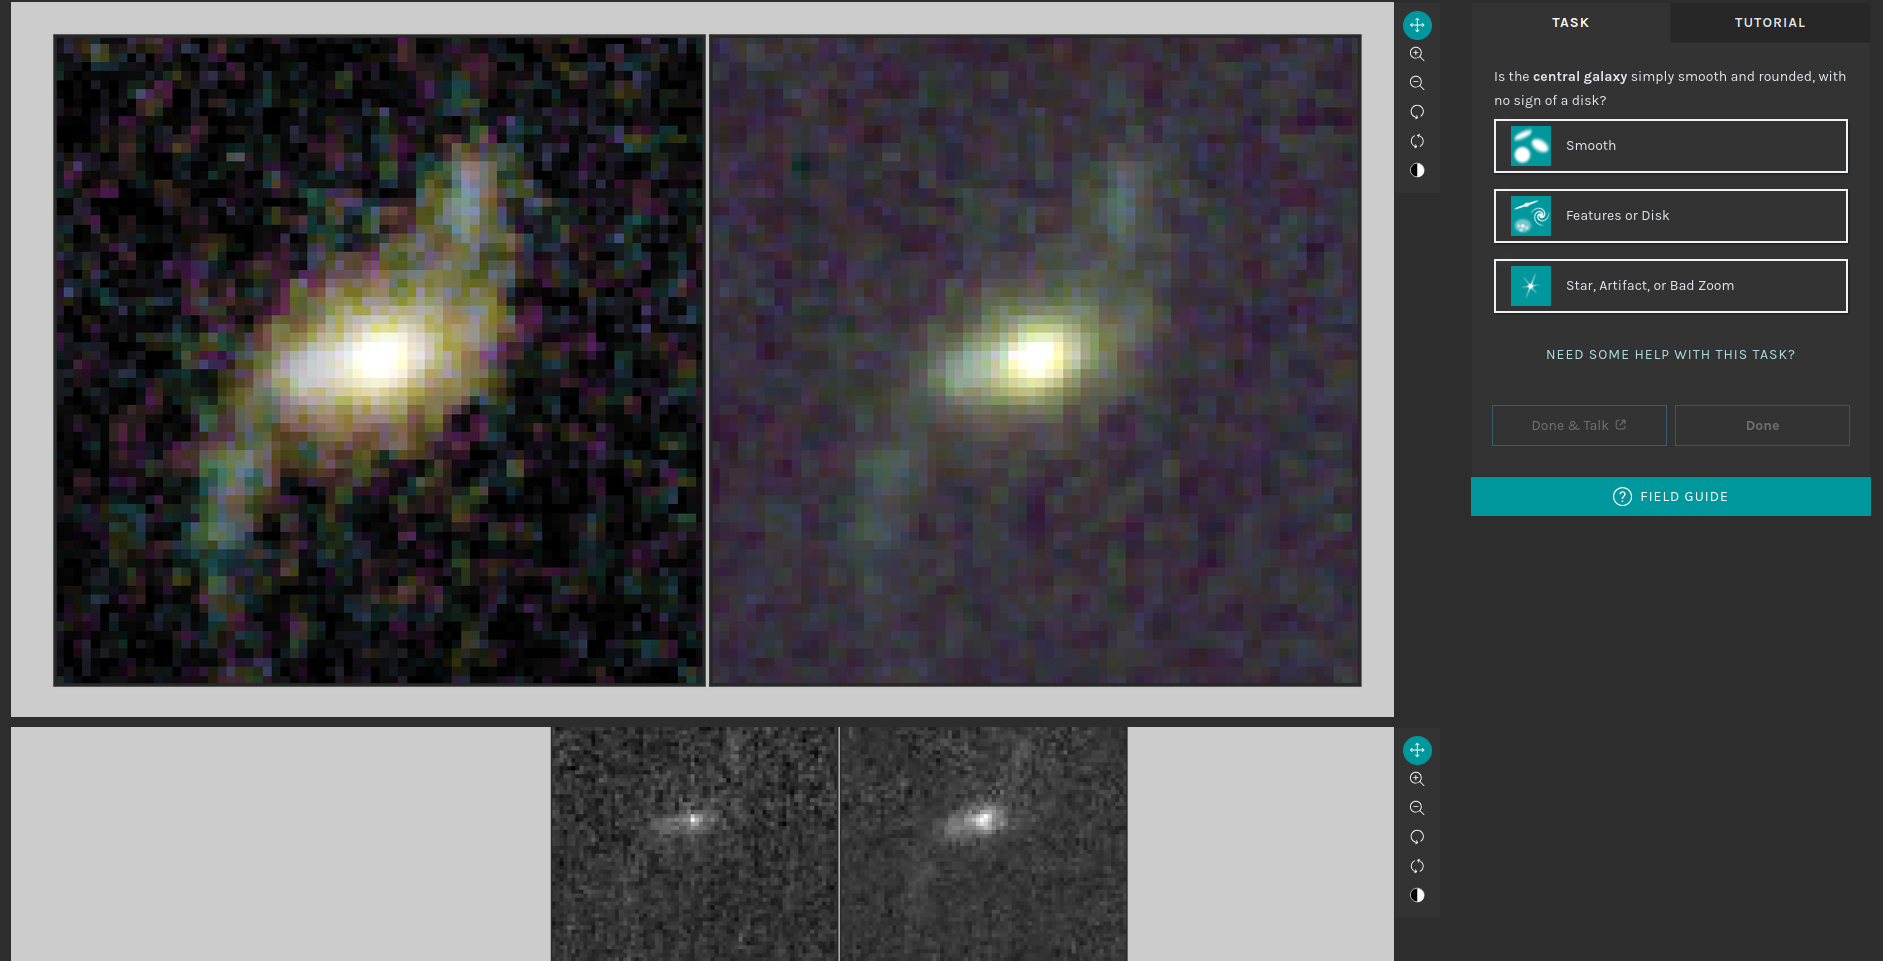
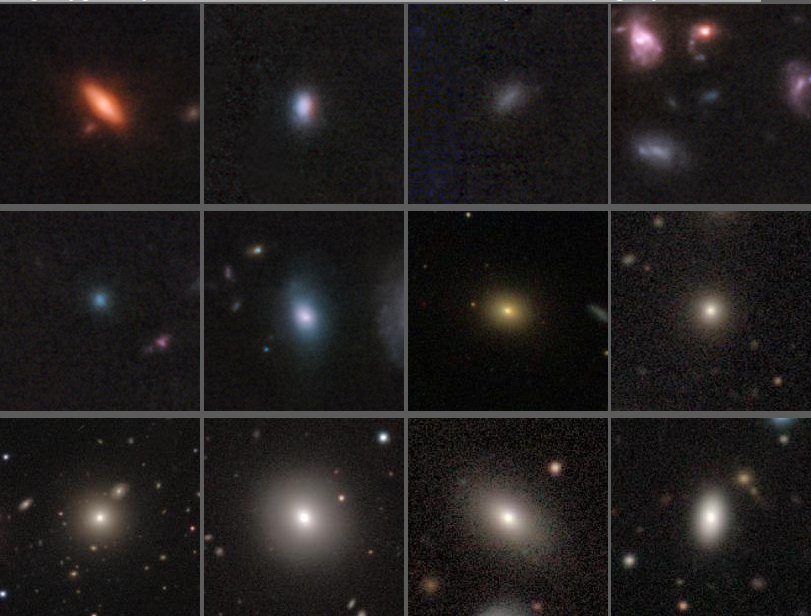
El flujo es así: te muestran una imagen y te preguntan si la galaxia es lisa o tiene rasgos. Según lo que respondes, te hacen la siguiente pregunta. Si dijiste “lisa”, nunca te van a preguntar por la barra. Si dijiste “tiene disco”, te preguntan si se ve de canto.
Dudé harto. Hubo galaxias donde estuve diez segundos entre dos opciones.
.h5El archivo pesa 2,54 GB comprimido; descomprimido en uint8 son ~3,5 GB, y al pasarlo a
float32 para entrenar se va a ~14 GB. En Colab, con ~12 GB de RAM, no cabe.
El primer intento fue una red densa sobre las imágenes crudas. Aplanar 256×256×3 hacia una
Dense(128) da 25.167.242 parámetros solo en esa capa, y el kernel se cayó.
def build_denselyconn(input_shape=(256, 256, 3), n_classes=10):
    inputs = keras.Input(shape=input_shape)
    x = layers.Rescaling(1./255)(inputs)
    x = layers.Flatten()(x)
    x = layers.Dense(128)(x)
    outputs = layers.Dense(n_classes, activation="softmax")(x)
    return keras.Model(inputs, outputs)
La solución fue dejar el array en uint8 y mover todo el preprocesamiento adentro del
modelo, como capas: Resizing para bajar resolución y Rescaling(1./255) para pasar a
float. Así la conversión ocurre por batch en la GPU, lo que vive en memoria ocupa cuatro
veces menos, y el .keras guardado acepta la imagen de 256×256 tal cual viene.
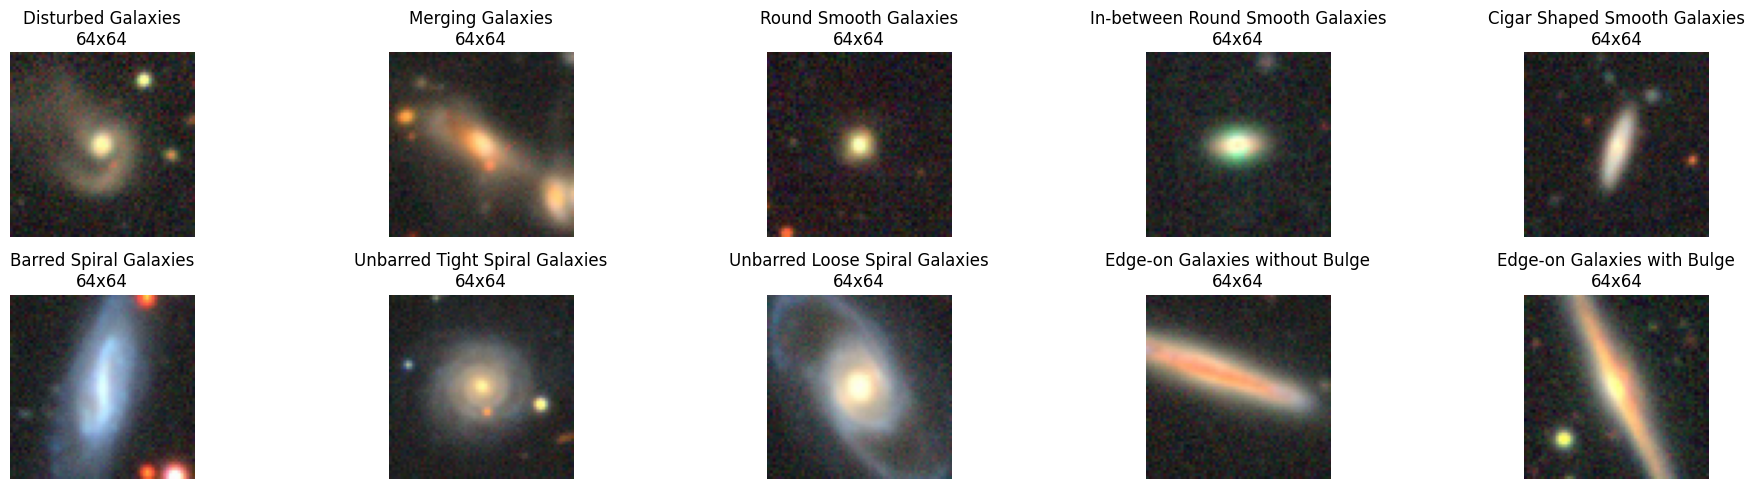
Galaxy10 no trae partición, así que la armé yo: estratificada, seed 42, guardando los índices. Train 12.060 / val 2.128 / test 3.548. El test no se toca hasta el final.
Para la métrica me comprometí antes de ver resultados. El baseline trivial lo explica mejor que cualquier argumento:
| Predecir siempre “Round Smooth” | Accuracy | Macro-F1 |
|---|---|---|
| 0.149 | 0.026 |
Es el mismo modelo estúpido medido de dos formas. En accuracy se ve como “casi 15%, no tan mal”. En macro-F1 se ve como lo que es: inútil, porque nueve de las diez clases tienen F1 cero. Con 8× de desbalance, accuracy te deja mentirte solo.
Me impuse escribir qué esperaba que pasara antes de ver un solo resultado. Si escribes las conclusiones después de ver la matriz de confusión, te acomodas a lo que viste y juras que eso era lo que pensabas.
Mirando las imágenes, las diez clases se agrupan en tres familias donde la silueta es la misma y solo cambia una cosa:
| Familia | Clases | Qué las separa |
|---|---|---|
| Smooth | Round · In-between · Cigar | la elongación: un continuo cortado en tres |
| Espirales | Barred · Unbarred Tight · Unbarred Loose | una barra central, y qué tan enrollados los brazos |
| Edge-on | sin bulbo · con bulbo | un abultamiento chico en el centro |
Disturbed y Merging no caen en ninguna familia.
Predicción 1. Cuando el modelo se equivoque, se va a equivocar dentro de una familia. No una espiral confundida con una lisa. Se falsifica si las celdas más grandes fuera de la diagonal caen fuera de las familias — que cubren solo 14 de 90 celdas.
Predicción 2. En el par Edge-on con bulbo / sin bulbo hay dos mecanismos que predicen direcciones opuestas: el prior dice que los errores van hacia “con bulbo” (la clase más frecuente), y la evidencia perdible dice lo contrario (un bulbo tenue se te pasa, pero nunca se alucina). La dirección que salga me dice cuál manda.
Partí de lo más simple —una red densa— y fui subiendo: CNN de una convolución, CNN con varios bloques. No a lo bruto: mirando en cada caso qué le pasaba a las curvas.
Lo primero que aprendí es que “hay overfitting” es una frase demasiado vaga. Los tres modelos tenían problemas distintos: la red densa subentrenaba (train y val pegadas y las dos bajas), la CNN de una capa sobreajustaba de libro, y la CNN profunda era la sana. Si les hubiera aplicado la misma receta a los tres, se la habría puesto justo al que necesitaba lo contrario.
macro-F1ma·cro·efe·u·no(s. m.)Promedio del F1 de cada clase, sin ponderar por tamaño: todas pesan igual.
| Modelo | Params | Val acc | Macro-F1 |
|---|---|---|---|
| Baseline trivial | 0 | 0.149 | 0.026 |
| Densa | 1.574.282 | 0.541 | 0.475 |
| CNN 1 conv | 7.875.722 | 0.566 | 0.507 |
| CNN profunda | 261.450 | 0.684 | 0.628 |
| CNN profunda + augment | 261.45030× menos parámetros | 0.789 | 0.751 |
La CNN de una convolución tiene 7.875.722 parámetros y saca 0.507 de macro-F1. La CNN profunda tiene 261.450 y saca 0.628. Treinta veces menos, doce puntos más.
La explicación está en dónde gasta los pesos cada una. La chica hace Flatten y después
una Dense(128): ese aplanamiento conecta cada píxel del mapa de features con cada
neurona, así que la capa aprende la posición exacta de cada píxel. Ahí se le va casi
todo, y es capacidad gastada en memorizar.
La profunda mantiene la información pasando por convoluciones —que comparten pesos y no
dependen de la posición absoluta— y cierra con un GlobalAveragePooling que la obliga a
resumir cada mapa en un número.
Buscando documentación me di cuenta de que había entendido mal para qué sirve.1 La pregunta no es “¿aplico augmentation o no?”, es qué transformaciones puedo aplicar sin cambiar la identidad del dato.
Acá tengo una ventaja concreta: no hay orientación privilegiada en el cielo. Una galaxia rotada 90 grados sigue siendo exactamente la misma clase. La transformación preserva la etiqueta de forma perfecta, no aproximada.
En MNIST no es que el augmentation sea inútil — es que hay que elegir con cuidado. Rotar un 6 lo suficiente lo convierte en un 9, y ahí no estás generando un ejemplo nuevo: estás enseñándole al modelo una etiqueta falsa. La misma operación, en un dominio distinto, pasa de ser correcta a ser dañina.
Lo que descarté, que es la parte que me obligó a pensar:
Algo que me confundió al principio: el augmentation no agrega datos. El array sigue teniendo las mismas imágenes y cada época cuesta lo mismo. Lo que cambia es que la imagen #47 le llega distinta cada vez. El efecto no es “más datos”, es que memorizar deja de funcionar.
Resultado: +12 puntos de macro-F1 (0.628 → 0.751).
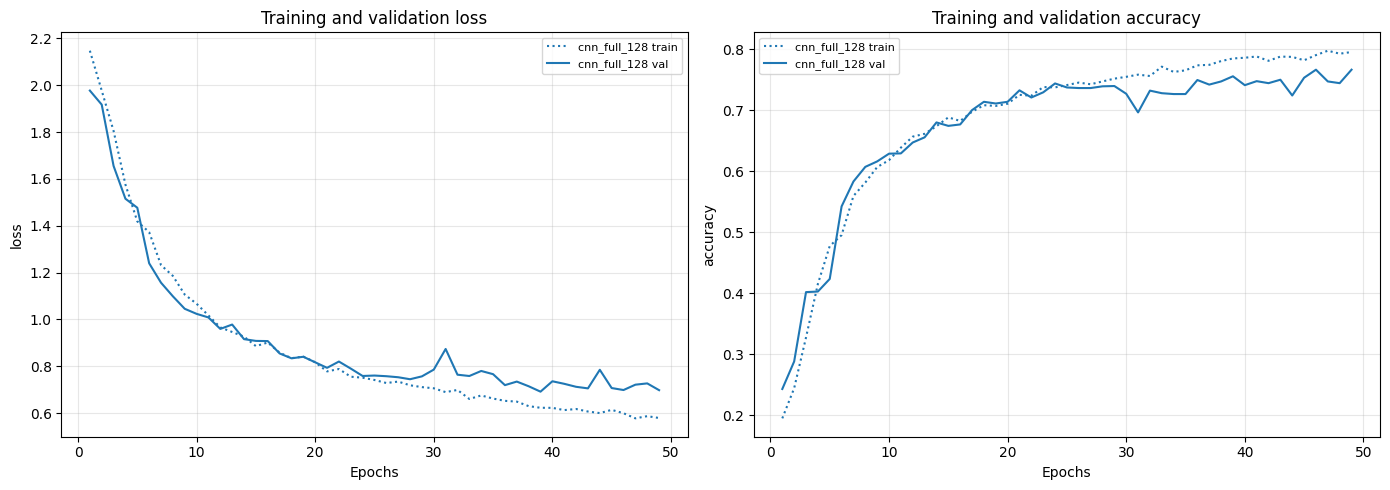
La matriz de abajo es la del modelo a 128×128 (el que salió peor en macro-F1). La uso porque es la corrida más reciente y porque los patrones de error son los mismos que en el modelo bueno, solo que un poco más marcados.
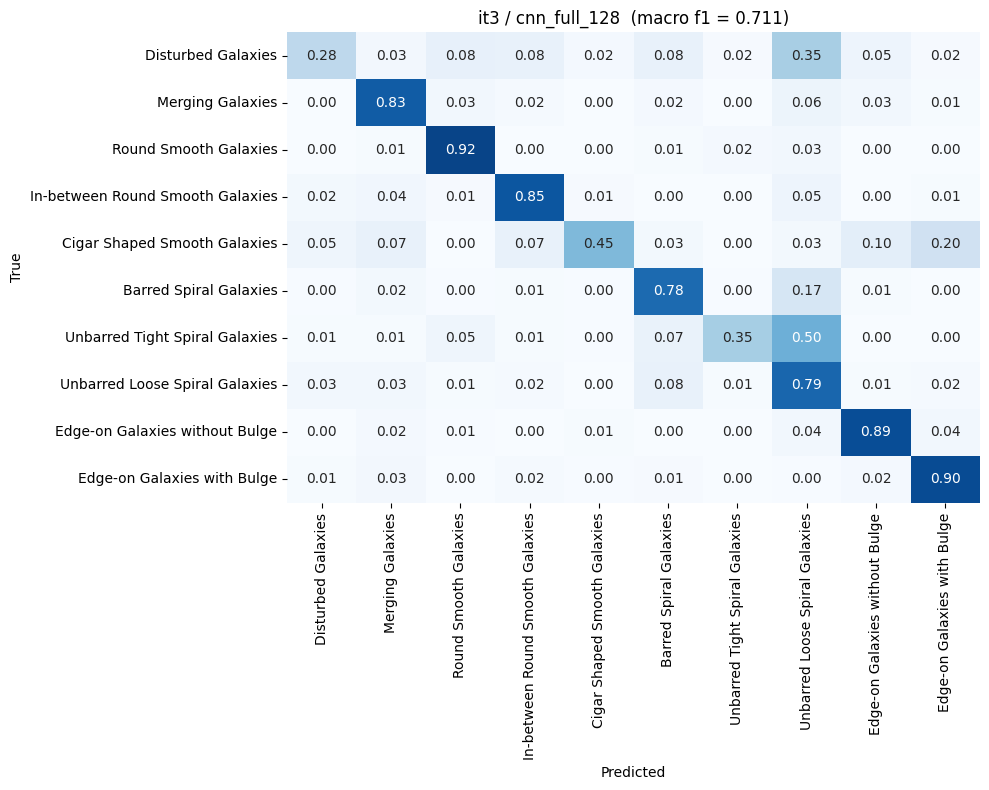
Ordené las celdas fuera de la diagonal de mayor a menor, quedándome con las que tuvieran al menos 10 casos para quitar ruido.
| Real → Predicho | n | Tasa | ¿Misma familia? |
|---|---|---|---|
| Unbarred Tight → Unbarred Loose | 109 | 0.495 | Sí |
| Disturbed → Unbarred Loose | 45 | 0.346 | No |
| Barred Spiral → Unbarred Loose | 41 | 0.167 | Sí |
| Disturbed → Round Smooth | 11 | 0.085 | No |
| Disturbed → In-between | 10 | 0.077 | No |
| Disturbed → Barred Spiral | 10 | 0.077 | No |
| Unbarred Loose → Barred Spiral | 24 | 0.076 | Sí |
De las cinco celdas más grandes, dos son de la misma familia y tres caen fuera. Y las tres de afuera son la misma fila: Disturbed.
Las familias que predije se comportan como dije: la celda más grande de toda la matriz es Unbarred Tight → Unbarred Loose, y las que siguen dentro de la familia espiral son todas barra / sin barra. Ninguna espiral se va a una smooth, ninguna smooth a una edge-on.
Lo que rompió la predicción no es que estuviera equivocada, es que estaba incompleta: no tenía ninguna historia para Disturbed.
Las dos clases Edge-on terminaron con recall 0.89 y 0.90, de las mejores de la matriz. Sin bulbo → con bulbo da 0.04 y al revés 0.02: con tan pocos errores ya no puedo decir hacia dónde fluyen.
Igual sirvió escribirla antes. Si no la hubiera dejado por escrito habría mirado la matriz y dicho “claro, obvio”, con cualquier resultado que hubiera salido.
Recall de 0.28, el peor de la matriz. Y no está confundida con una clase: el 35% se va a Unbarred Loose y el resto se reparte entre Round Smooth, In-between y Barred Spiral. Tres familias distintas.
Esa firma es distinta a cualquier otra confusión. Unbarred Tight → Unbarred Loose es “dos cosas parecidas”. Esto es otra cosa: “perturbada” no es una forma, es una anotación sobre cualquier forma. Una galaxia perturbada muchas veces es una espiral, con asimetría.
Fui a buscar si le pasaba a alguien más y encontré un paper que clasifica este mismo dataset con ResNet101, a 224×224, sin recorte y con las clases balanceadas. Reportan que su mayor confusión de Disturbed también es con Unbarred Loose Spiral.2
No saco de ahí una conclusión definitiva — es un solo paper y no repliqué su setup. Pero me deja una sospecha razonable: que un modelo bastante más potente que el mío se confunda en el mismo lugar sugiere que subir capacidad quizás no arregle esta clase en particular. Por ahora lo dejo anotado y no me meto más ahí, que es un agujero en el que se puede perder mucho tiempo.
Este proyecto ya me dio lo que venía a buscar, así que lo dejo acá y anoto lo que queda por probar, para no quedarme dando vueltas en el mismo dataset:
Transfer learning también está pendiente, pero ese lo quiero abordar aparte: es un tema suficientemente grande como para merecer su propio proyecto en vez de ser el apéndice de este.
Siguiente registro: cuánto de lo que me falta es resolución y cuánto es el dato.
El notebook completo, con todas las corridas: TODO: pegar la URL de Google Colab.
Lo que leí para entenderlo: Data augmentation is not necessarily about more data · Data augmentation — TensorFlow · Data Augmentation (video) ↩
Classifying galaxies in the Galaxy10 DECals dataset using Inception and Residual CNNs. arXiv:2606.08826 ↩